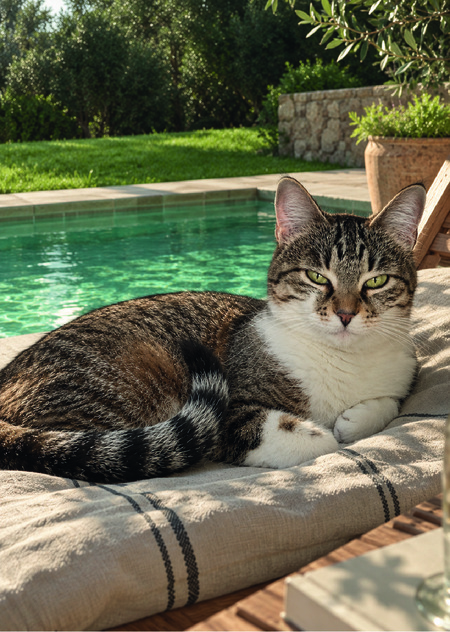
Концепция
Концепция проекта — исследовать, как нейросеть может запомнить образ конкретного персонажа и воспроизводить его в совершенно новых условиях.Для обучения я выбрала свою кошку Еву, потому что это знакомый мне образ, внешность которого я хорошо знаю и могу оценить, насколько точно модель сохраняет её особенности.Я собрала датасет из фотографий Евы и обучила на нём собственную LoRA-модель. После обучения Ева помещается в ситуации, которых не было на исходных фотографиях: в сад, снег, новый интерьер и другие пространства.Таким образом, проект показывает переход от реального образа к его цифровой интерпретации и исследует, насколько нейросеть способна сохранить узнаваемость конкретного персонажа.
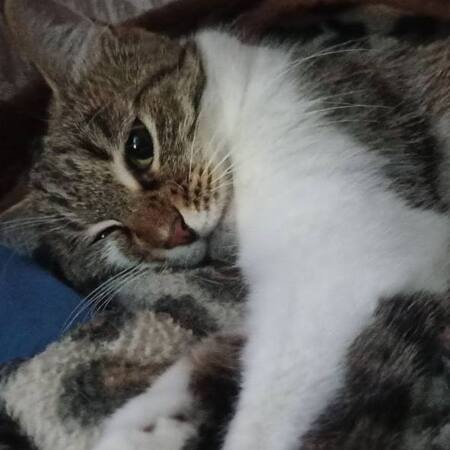
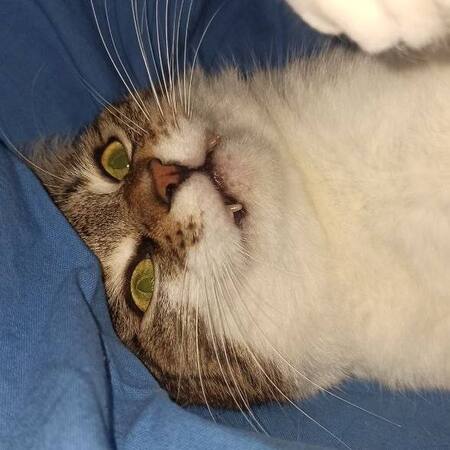
Примеры исходных изображений. Ева моя самая любимая кошка. Она — то самое существо с сознанием и умом, как у человека.
Идея проекта
Идея проекта — создать цифровую версию Евы, с помощью которой можно получать новые фотографии без реальной съёмки. Используя небольшую коллекцию существующих снимков, я создаю инструмент, позволяющий помещать её в любые придуманные ситуации и локации — от домашнего интерьера до зимнего леса.
Исходники для обучения
В датасете итого 20 фотографий в квадрате 1:1. Снимки были сделаны разные, но все дома. Я старалась подобрать фотографии, где Ева не в спокойной стандартной позе, а где, например, играется или спит в необычной позе, чтобы проект и итог вышел интересным.
// поэтапная разработка проекта
// ПЕРВЫЙ ЭТАП
установка необходимых элементов
ЯЧЕЙКА 1. Проверка GPU
! nvidia-smi
Проверяем подключение видеокарты, которая будет использоваться для обучения модели.
ЯЧЕЙКА 2. Установка основных библиотек
! pip install bitsandbytes transformers accelerate peft datasets -q
Устанавливаем библиотеки, необходимые для работы и обучения LoRA-модели.
ЯЧЕЙКА 3. Установка Diffusers
Устанавливаем библиотеку diffusers из GitHub. Она нужна для работы с моделями Stable Diffusion.
ЯЧЕЙКА 4. Обновление TorchAO
Устанавливаем/обновляем torchao, необходимый для корректной работы окружения и оптимизации вычислений.
ЯЧЕЙКА 5. Загрузка скрипта обучения
Скачиваем готовый скрипт train_dreambooth_lora_sdxl.py, с помощью которого дальше будем обучать LoRA на базе SDXL.
// ВТОРОЙ ЭТАП
подготовка собственного датасета
ЯЧЕЙКА 6. Создание папки датасета
Создаём папку my_cat, в которой будут храниться исходные фотографии Евы.
ЯЧЕЙКА 7. Загрузка фотографий
Загружаем собственные фотографии Евы в созданную папку.
ЯЧЕЙКА 8. Просмотр датасета
Выводим загруженные фотографии в виде сетки, чтобы проверить датасет перед дальнейшей работой.
// ТРЕТИЙ ЭТАП
подготовка фотографий к обучению
ЯЧЕЙКА 9. Подключение BLIP
Загружаем модель BLIP Image Captioning, которая умеет автоматически описывать содержание фотографий.
ЯЧЕЙКА 10. Создание описаний
BLIP анализирует фотографии Евы и автоматически создаёт текстовое описание для каждого изображения.
ЯЧЕЙКА 11. Добавление токена EVACAT
В описания добавляем уникальный токен EVACAT. Он используется как специальное обозначение именно Евы во время обучения.
ЯЧЕЙКА 12. Создание metadata.jsonl
Сохраняем названия фотографий и их текстовые описания в файл metadata.jsonl, который затем используется при обучении.
// ЧЕТВЕРТЫЙ ЭТАП
обучение LoRA-модели
ЯЧЕЙКА 13. Настройка параметров обучения
Указываем базовую модель SDXL, папку с датасетом, разрешение изображений, количество шагов и другие параметры.
ЯЧЕЙКА 14. Запуск обучения
Запускаем DreamBooth LoRA. В качестве основы используется Stable Diffusion XL 1.0, которую мы дообучаем на фотографиях Евы.
ЯЧЕЙКА 15. Обучение в течение 500 шагов
Модель постепенно учится связывать токен EVACAT с внешностью Евы. Во время обучения создаются промежуточные сохранения.
ЯЧЕЙКА 16. Сохранение результата
Получаем файл pytorch_lora_weights.safetensors — это обученные веса нашей LoRA.
// ПЯТЫЙ ЭТАП
сохранение модели
ЯЧЕЙКА 17. Авторизация в Hugging Face
Входим в аккаунт Hugging Face, чтобы сохранить обученную модель.
ЯЧЕЙКА 18. Создание репозитория
Создаём отдельный репозиторий для нашей LoRA-модели.
ЯЧЕЙКА 19. Загрузка модели
Загружаем полученные веса eva_cat_LoRA на Hugging Face.
// ШЕСТОЙ ЭТАП
подключение обученной модели
ЯЧЕЙКА 20. Загрузка SDXL
Снова загружаем базовую модель Stable Diffusion XL.
ЯЧЕЙКА 21. Подключение LoRA Евы
К SDXL подключаем обученные веса eva_cat_LoRA.
ЯЧЕЙКА 22. Настройка силы LoRA
Устанавливаем lora_scale = 0.5, чтобы контролировать влияние обученной LoRA на результат.
// СЕДЬМОЙ ЭТАП
генерация новых изображений
ЯЧЕЙКА 23. Создание первого промпта
Пишем запрос с токеном EVACAT и задаём новое окружение для Евы.
ЯЧЕЙКА 24. Генерация изображения
Модель создаёт изображение Евы в новой ситуации, которой не было в исходном датасете.
ЯЧЕЙКИ 25–26. Эксперименты с промптами
Меняем описание окружения и генерируем Еву в разных условиях: в саду, зимнем лесу, на кровати и других локациях.
// основные ячейки с кодами
1. Ячейка с кодом № 12 — создание описаний и токена EVACAT
import json
caption_prefix = «a photo of EVACAT cat, „
with open (f'{local_dir}metadata.jsonl', 'w') as outfile:
for img in imgs_and_paths:
caption = caption_prefix + caption_images (img[1]).split („\n“)[0]
entry = {
„file_name“: img[0].split („/“)[-1],
„prompt“: caption
}
json.dump (entry, outfile)
outfile.write ('\n')
2. Ячейка с кодом № 18 — обучение LoRA
! accelerate launch train_dreambooth_lora_sdxl.py <br> --pretrained_model_name_or_path="stabilityai/stable-diffusion-xl-base-1.0» <br> --pretrained_vae_model_name_or_path="madebyollin/sdxl-vae-fp16-fix» <br> --dataset_name="my_cat» <br> --output_dir="eva_cat_LoRA» <br> --caption_column="prompt» <br> --mixed_precision="fp16» <br> --instance_prompt="a photo of EVACAT cat» <br> --resolution=512 <br> --train_batch_size=2 <br> --gradient_accumulation_steps=3 <br> --gradient_checkpointing <br> --learning_rate=1e-4 <br> --snr_gamma=5.0 <br> --lr_scheduler="constant» <br> --lr_warmup_steps=0 <br> --use_8bit_adam <br> --max_train_steps=500 <br> --checkpointing_steps=250 <br> --seed="0»
3. Ячейка с кодом № 25 — подключение обученной LoRA
vae = AutoencoderKL.from_pretrained (
«madebyollin/sdxl-vae-fp16-fix»,
torch_dtype=torch.float16
)
pipe = DiffusionPipeline.from_pretrained (
«stabilityai/stable-diffusion-xl-base-1.0»,
vae=vae,
torch_dtype=torch.float16,
variant="fp16»,
use_safetensors=True
)
pipe.load_lora_weights («eva_cat_LoRA»)
pipe.fuse_lora (lora_scale=0.5)
_ = pipe.to («cuda»)
4. Ячейка с кодом № 26 — финальная генерация
prompt = «a photo of EVACAT cat, sitting in a green garden among flowers, looking at the camera, realistic photography»
image = pipe (
prompt=prompt,
num_inference_steps=25
).images[0]
image
// получившиеся изображения
Итоговое изображение (1) Ева лежит на кровати
Итоговое изображение (2) Ева в саду среди цветов